第16話
Transformer
アテンションの正体
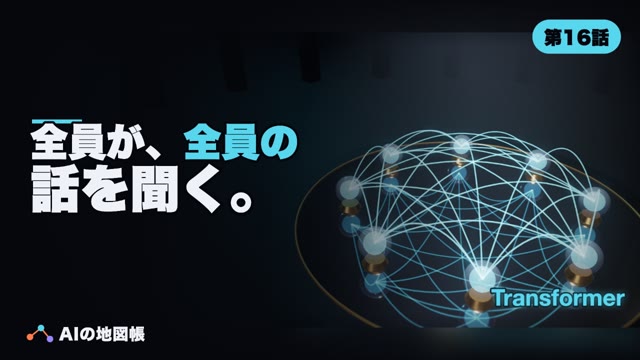
全部の単語が、全部の単語を同時に見る。いまのAIのほぼ全部の土台になった「アテンション」の仕組みと、その弱点を5分で。
この動画で話すこと
会議で全員が全員の発言を同時に聞く。人間には無理なこのやり方を、機械にやらせたのが Transformer です。伝言ゲーム方式だった昔のAIと何が違うのか、「アテンション」とは何の点数なのか、なぜGPUと相性がよかったのか、そして弱点まで、5分で。
章
- 全員が全員の話を聞く会議
- 今日の現在地
- 昔は伝言ゲーム方式
- 2017年の論文
- アテンション=注目の点数
- 一斉に計算できる
- 順番をどう伝えるか
- 画像にも、タンパク質にも
- 弱点:長さの2乗
- ちゃんと聞くだけで
- 次に見るなら
- 応援のお願い
ナレーション全文
会議で、全員が、全員の発言を、同時に、一言も漏らさず聞いている。人間なら、地獄です。
ところが、これを本当にやる機械があります。いま話題のAIの多くは、その上に建っています。
2017年より前、文章を扱うAIは、伝言ゲーム方式でした。単語を1つ読んでは、要約して、次へ渡す。
文が長いと、最初のほうの話は、途中で薄まります。しかも、順番にしか進めない。計算機を何台並べても、列は1本のままです。
2017年、8人の研究者が、1本の論文を出します。題名は、「必要なのは、アテンションだけ」。
伝言ゲームを、やめる。代わりに、すべての単語が、すべての単語を、直接見る。
たとえば、「猫がネズミを追いかけた。それは、チーズを落とした」。ここで言う「それ」とは、猫でしょうか、ネズミでしょうか。
まわりの単語すべてに、どれくらい注目するか、点数をつける。「チーズ」と「落とした」に引っぱられて、ネズミだ、と決まる。この点数づけが、アテンションです。
誰の話を、どれくらい聞くか。それを、単語ごとに、全員ぶん、同時に計算します。
順番待ちがないので、計算は一斉にできます。これが、もともと絵を描くための部品だったGPUと、相性抜群でした。
学習は、大きいほうのモデルでも、GPU8個で、3日半。それで、当時の機械翻訳の最高記録を、塗り替えました。
ちなみに、8人の著者には、こんな注釈がついています。「貢献は同等。名前の順番はランダム」。全員が全員に注目する論文は、著者まで平等でした。
ただ、全員を同時に見ると、困ることがひとつ。順番が、分からなくなります。「猫がネズミを追う」と、「ネズミが猫を追う」が、同じに見える。
そこで、単語ひとつひとつに、何番目かを示す番号札を貼りました。札の模様は、波の重ね合わせです。
この仕組み、言葉専用では、ありませんでした。画像を小さなタイルに切って並べれば、画像に。アミノ酸を並べれば、タンパク質に使えます。
日本でも2024年、スーパーコンピュータ「富岳」で、国産の大規模な言語モデルが学習されました。土台は、同じ仕組みです。
弱点は、会議の人数です。全員が全員を見るので、単語が2倍になると、手間は4倍。10倍なら、100倍。
長い文書を読ませるほど、計算が、2乗で効いてくる。出席者を増やすと急に長引くのは、人間の会議と同じです。
計算の無駄を削る工夫や、別の方式と組み合わせる研究が、いまも続いています。
全員の話を、全員が聞く。人間には無理なやり方を機械にやらせたら、言葉も、画像も、タンパク質も、読めるようになりました。
次の会議で、誰も聞いていないな、と思ったら、思い出してください。ちゃんと聞くだけで、世界は変わるそうです。
出典・参考
- Vaswani et al., "Attention Is All You Need" (2017) https://arxiv.org/abs/1706.03762
- Dosovitskiy et al., "An Image is Worth 16x16 Words" (2020) https://arxiv.org/abs/2010.11929
- Jumper et al., Nature 596, 583 (2021)(AlphaFold)
- Dao et al., "FlashAttention", NeurIPS (2022)
- 富士通ほか プレスリリース(2024年5月10日、スーパーコンピュータ「富岳」で学習した大規模言語モデル)